В сентябре я вручную разметила часть обсуждения с юристами и сравнила нашу связку GigaAM v3 + Community-1 с внешним сервисом диаризации. На первых 32 минутах записи DER составил 6,50% у Community-1 против 30,65% у внешнего сервиса. Этот результат стал продолжением работы, которую мы начали в конце августа: сравнивали модели на коротких фрагментах, исправляли назначение спикеров словам и собирали инструменты для ручной разметки — эталона, с которым можно сравнивать автоматический результат.
Меня зовут Алёна Господинова. Я занимаюсь в том числе обработкой записей очных встреч. Основные эксперименты мы провели в конце августа и сентябре 2026 года, а в начале октября продолжили развивать редактор, чтобы проверяющие могли готовить независимые эталоны для следующих сравнений.
Что такое диаризация и зачем она нужна
Диаризация отвечает на вопрос «кто когда говорил». Алгоритм делит аудиозапись на интервалы речи и присваивает им метки: «Спикер 1», «Спикер 2» и так далее. Если первый участник заговорит снова, система должна вернуть ему прежнюю метку. Само слово «спикер» здесь означает участника, чей голос слышен в записи.
Встреча нужна нам как источник договорённостей и задач. Для этого мало правильно записать слова: нужно сохранить, кто их произнёс. Если предложение одного участника приписать другому, последующий анализ может неверно определить автора решения или ответственного.
В записи из переговорной несколько голосов попадают в одну дорожку. Люди перебивают друг друга, отвечают коротким «да», говорят одновременно и сидят на разном расстоянии от микрофона. В таких условиях системе сложно удерживать один и тот же голос за одной меткой. Установить имя человека по технической метке вроде speaker_2 — отдельная задача.
В конце августа мы начали с эксплуатационного сравнения GigaAM v3, faster-whisper и SaluteSpeech. На записи длительностью 1 час 32 минуты GigaAM обработала текст примерно за 8 минут, faster-whisper — за 1 час 42 минуты. На второй записи направление сохранилось. Но ручного текстового эталона тогда ещё не было: согласие моделей между собой позволяло искать подозрительные места, а измерить WER по нему было нельзя. GigaAM стала основным локальным кандидатом по скорости и наблюдаемой устойчивости; качество распределения реплик потребовало отдельного исследования.
Что такое DER и как мы измеряли ошибки
DER (Diarization Error Rate) — доля ошибок диаризации, рассчитанная по времени. Мы вручную отмечаем, кто и когда говорит, и сравниваем результат модели с этой эталонной разметкой. Метрика складывает три вида ошибок: система пропустила речь, приняла тишину или шум за речь либо приписала голос другому участнику. Суммарное время этих ошибок делится на общее время речи спикеров в эталоне.
Например, участники говорят по очереди, и в эталоне отмечено 100 секунд речи. Если ошибки в сумме заняли 10 секунд, DER равен 10%. Чем он меньше, тем лучше. При одновременной речи время считается для каждого говорящего: две секунды разговора двух людей дают четыре секунды эталонной речи. Поэтому DER нельзя читать как процент неверных слов или просто как долю испорченной длительности аудиофайла.
Я разделила проверку на три вопроса: правильно ли распознаны слова, правильно ли выделены голоса во времени и правильно ли слова распределены между участниками. Эти ошибки могут возникать независимо друг от друга.
| Метрика | Что показывает |
|---|---|
| WER | Ошибки распознавания текста: замены, удаления и вставки слов относительно эталона. Назначение спикера не оценивает. |
| DER | Ошибки во времени: пропущенную речь, ложное обнаружение речи и перепутанного спикера. Знаменатель — суммарное эталонное время речи спикеров, с учётом правил оценки перекрытий. |
| cpWER | Ошибки текста после объединения слов по спикерам и выбора наилучшего соответствия меток между системой и эталоном. Учитывает потери при неправильном распределении слов. |
| Ошибка спикера по словам | Отдельную диагностическую оценку назначения спикера слову. В отчётах она приведена рядом с текстовыми и временными метриками. |
Для DER существенен collar — область около эталонных границ, которую исключают из подсчёта. При collar=0 такого допуска нет. Для русских фрагментов основной результат считали на обычной временной шкале с включённой одновременной речью. Определения параметров описаны в документации pyannote.metrics, а cpWER — в MeetEval.
В первом отчёте текстовая метрика с учётом спикеров обозначена как «SA-WER / cpWER micro». Ниже сохраняю название SA-WER для его результатов. Micro означает, что ошибки суммируются по фрагментам и делятся на общее число эталонных слов.
Community-1 против pyannote 3.1: девять русских фрагментов
С 28 августа по 1 сентября мы сравнили speaker-diarization-3.1 и speaker-diarization-community-1. Это названия моделей: в экспериментах первая работала с библиотекой pyannote.audio 3.4, вторая — в отдельном окружении pyannote.audio 4.0.7.
Вручную размеченный набор включал девять русских фрагментов: контрольную запись из Телемоста, части стратсессии и офисной встречи. Число спикеров модели определяли автоматически.
| Фрагмент | Спикеров в эталоне | Найдено: 3.1 / C1 | DER 3.1 | DER C1 |
|---|---|---|---|---|
| A | 4 | 3 / 4 | 12,74% | 9,82% |
| B | 2 | 2 / 2 | 2,15% | 3,60% |
| C | 2 | 2 / 2 | 0,87% | 0,79% |
| D | 3 | 3 / 3 | 1,01% | 0,42% |
| E | 2 | 2 / 2 | 0,93% | 0,93% |
| F | 3 | 2 / 3 | 8,02% | 5,96% |
| G | 2 | 3 / 2 | 4,40% | 1,87% |
| H | 2 | 2 / 2 | 2,34% | 3,60% |
| I | 4 | 3 / 4 | 14,60% | 10,74% |
Community-1 дала меньший DER на шести фрагментах, тот же результат на одном и больший на двух. Среднее арифметическое по девяти фрагментам снизилось с 5,23% до 4,19%. Число участников Community-1 определила правильно во всех девяти случаях, pyannote 3.1 — в пяти.
Для меня особенно показательны F, G и I: прежняя модель то объединяла разных людей, то создавала лишнего спикера. Community-1 исправила число кластеров на всех трёх. При этом на B и H число спикеров совпало с эталоном у обеих моделей, а DER новой модели оказался хуже. Сам по себе правильный подсчёт голосов ещё не гарантирует правильные границы и назначения.
Это небольшая направленно отобранная выборка с одним проверяющим. A и B сохранились как исторические агрегаты; для C–I в рабочем наборе сохранены ручная разметка и выходы моделей. Среднее по девяти фрагментам нельзя переносить на все русскоязычные встречи.
Дополнительно мы проверили влияние числа спикеров на одной встрече NOTSOFAR-1 — MTG_32110. В автоматическом режиме pyannote 3.1 нашла восемь спикеров вместо семи и получила DER 60,22%; Community-1 нашла семь и получила 55,18%. Когда старой модели заранее сообщили правильное число участников, её DER снизился до 57,68%. Таким образом, на этой конкретной встрече число кластеров объяснило около половины разницы. Высокие абсолютные ошибки на NOTSOFAR-1 также показывают, насколько результат зависит от записи и условий.
Спикера пришлось назначать каждому слову
Отдельная проблема находилась на стыке распознавания и диаризации. Один сегмент автоматического распознавания речи (ASR) может содержать реплики нескольких людей. Если назначить всему сегменту одного спикера, часть слов получит неверного автора даже при хорошей акустической разметке.
Мы перешли к назначению спикера по временным меткам каждого слова. При смене голоса внутри сегмента формируется отдельная реплика. Исходная последовательность слов при этом сохраняется. Если назначение неоднозначно, слово получает неизвестного спикера.
На синтетической записи с пятью сменами спикера переход от назначения целому сегменту к пословному совмещению снизил SA-WER с 57,14% до 17,46%. WER остался 17,46%, а DER — 1,81%. Здесь выигрыш дала именно стыковка текста и голосов: при пословном режиме обе сравниваемые модели получили одинаковые текстовые метрики.
На реальных офисных фрагментах F, G и I мы затем использовали одну и ту же последовательность слов GigaAM и ручной текстовый эталон: три фрагмента по 180 секунд, всего 1 260 эталонных слов.
| Метрика, F/G/I | pyannote 3.1 | Community-1 |
|---|---|---|
| WER GigaAM | 12,46% | 12,46% |
| SA-WER, micro | 32,70% | 17,14% |
| Ошибка назначения спикера слову | 11,78% | 1,64% |
| Слова с неизвестным спикером | 7,95% | 0,55% |
| DER, collar 0 | 9,11% | 6,28% |
При неизменном тексте SA-WER снизился на 15,56 процентного пункта, или примерно на 47,6% относительно результата pyannote 3.1. Для назначения единственного спикера слову мы использовали exclusive-разметку Community-1. Обычную временную шкалу сохранили отдельно для DER и анализа одновременной речи.
Эталон F/G/I проверял один человек. Из оценки исключили 12 неразборчивых реплик, а с учётом связанных пересечений — 22 из 152 реплик. Поэтому эти цифры характеризуют оценённую часть трёх фрагментов. Другой полезный отрицательный результат: фильтр интервалов короче 0,5 секунды ухудшил средний DER офисного набора E–I у обеих моделей. В основном сравнении мы его отключили.
Обсуждение с юристами: сравнение с внешним сервисом
После коротких фрагментов я взяла более длинную запись обсуждения с юристами. Ручную доразметку оценённой части закончила 9 сентября. В отчёте зафиксирован оценённый срез 00:00:00–00:32:05.124: 4 061 слово для WER и 4 060 слов для метрик с учётом спикеров.
| Метрика | GigaAM + C1 | Внешний сервис |
|---|---|---|
| WER | 3,50% | 13,47% |
| cpWER | 11,85% | 40,57% |
| Ошибка спикера по словам | 4,94% | 22,87% |
| DER · collar 0 | 6,50% | 30,65% |
| DER · collar 0,25 | 5,79% | 28,41% |
При нулевом collar разница DER составила 24,15 процентного пункта. При collar 0,25 секунды преимущество сохранилось: 5,79% против 28,41%. У внешнего сервиса я проверила общий и телефонный режимы. На этой записи значения всех приведённых метрик совпали, поэтому в таблице оставлена одна колонка. На других записях режимы могут различаться.
Мы также проверили накопительные срезы примерно на 8, 16, 24 и 32 минутах. На каждом GigaAM + Community-1 сохраняла преимущество по WER и cpWER. Например, cpWER внешнего сервиса вырос с 19,59% на первом срезе до 40,57% на последнем; у нашей связки эти значения составили 12,67% и 11,85%. Срезы вложены друг в друга и не являются четырьмя независимыми экспериментами.
Способ подготовки эталона мог дать преимущество нашей связке. Текстовый эталон первоначально построен из слов GigaAM, а эталон диаризации получен ручной коррекцией Community-1. Поэтому низкие WER и cpWER GigaAM могут быть оптимистичными; DER тоже требует повторной проверки на независимо размеченных данных. Из оценки исключены 14,321 секунды и 9 слов: штатные исключения, две незавершённые строки и связанные перекрытия.
По этому замеру я могу сказать, что наша связка заметно лучше прошла оценённую часть обсуждения с юристами. Сделать из него общий рейтинг сервисов или обещание DER 6,50% на любой встрече было бы преждевременно. Для следующего сравнения нужны полностью вычитанный текст, независимые акустические интервалы и новые записи.
Как ручная проверка превратилась в редактор эталона
Разметка оказалась трудоёмкой. Чтобы исправить спорный участок, приходится несколько раз прослушивать короткий фрагмент, возвращаться к соседним репликам и уточнять границы. После разметки обсуждения с юристами я решила продолжать сравнения с помощью отдела тестирования — QA. Для этого тестировщику нужен удобный рабочий инструмент.
Первая версия QA-интерфейса появилась в начале сентября. Администратор передаёт встречу в очередь, проверяющий последовательно прослушивает реплики, подтверждает спикера или меняет его и переходит дальше. Можно добавить пропущенного участника, отметить одновременную речь и другие проблемы, а неоднозначный фрагмент оставить с отметкой «Невозможно определить».
Автоматический результат и ручные исправления хранятся раздельно. Незавершённую проверку можно продолжить, а повторная обработка встречи сохраняет опубликованную ручную версию. Это позволяет сопоставлять исходную ошибку с исправлением и не терять работу тестировщика при очередном прогоне модели.
К концу сентября мы выделили полноценный режим эталонной разметки. Он решает более широкую задачу, чем исправление подписи под готовой репликой.
| Слой | Что делает проверяющий | Для какой оценки |
|---|---|---|
| Текст | Вычитывает черновик, исправляет слова, указывает спикера и подтверждает каждую реплику по аудио. | WER и метрики текста с учётом спикеров |
| Акустические интервалы | Отдельно размечает начало и конец речи каждого спикера. Пересекающиеся интервалы разных людей обозначают одновременную речь. | DER |
Такое разделение принципиально: удобная для чтения текстовая реплика может объединять несколько участков речи с паузами. Если использовать её границы как акустический эталон, паузы попадут в разметку и изменят DER.
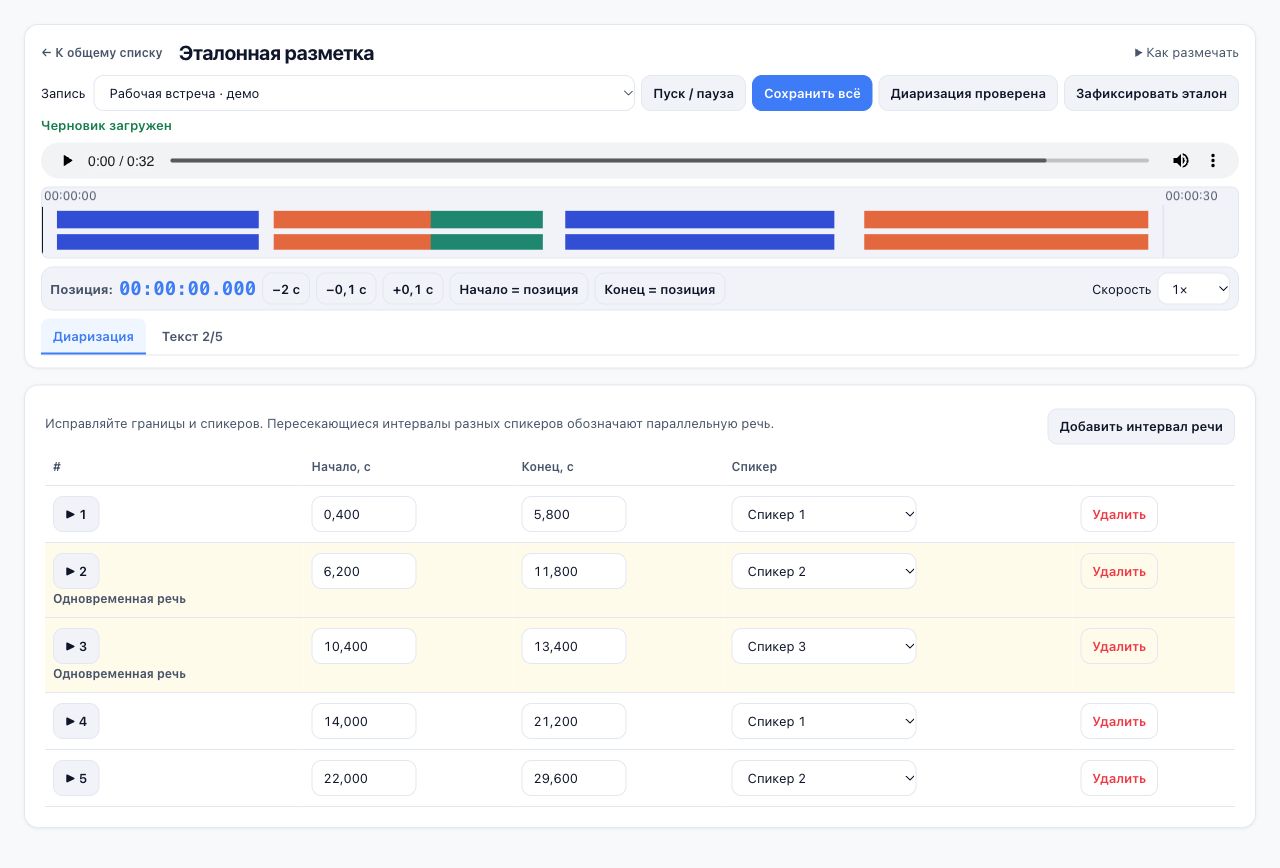
Для новых текстовых черновиков выбрали faster-whisper large-v3, который не участвует в запланированном сравнении. Это уменьшает прямую зависимость заготовки от оцениваемых систем, но каждый фрагмент всё равно нужно вычитать по аудио. Акустический слой создаётся отдельно и остаётся пустым до ручной работы.
В редакторе есть управление скоростью, точное перемещение на 0,1 секунды и установка границы по текущей позиции плеера. Завершение проверки создаёт фиксированную версию эталона. Система сверяет контрольную сумму аудио, проверяет допустимость интервалов и защищает разметку от одновременной перезаписи двумя пользователями.
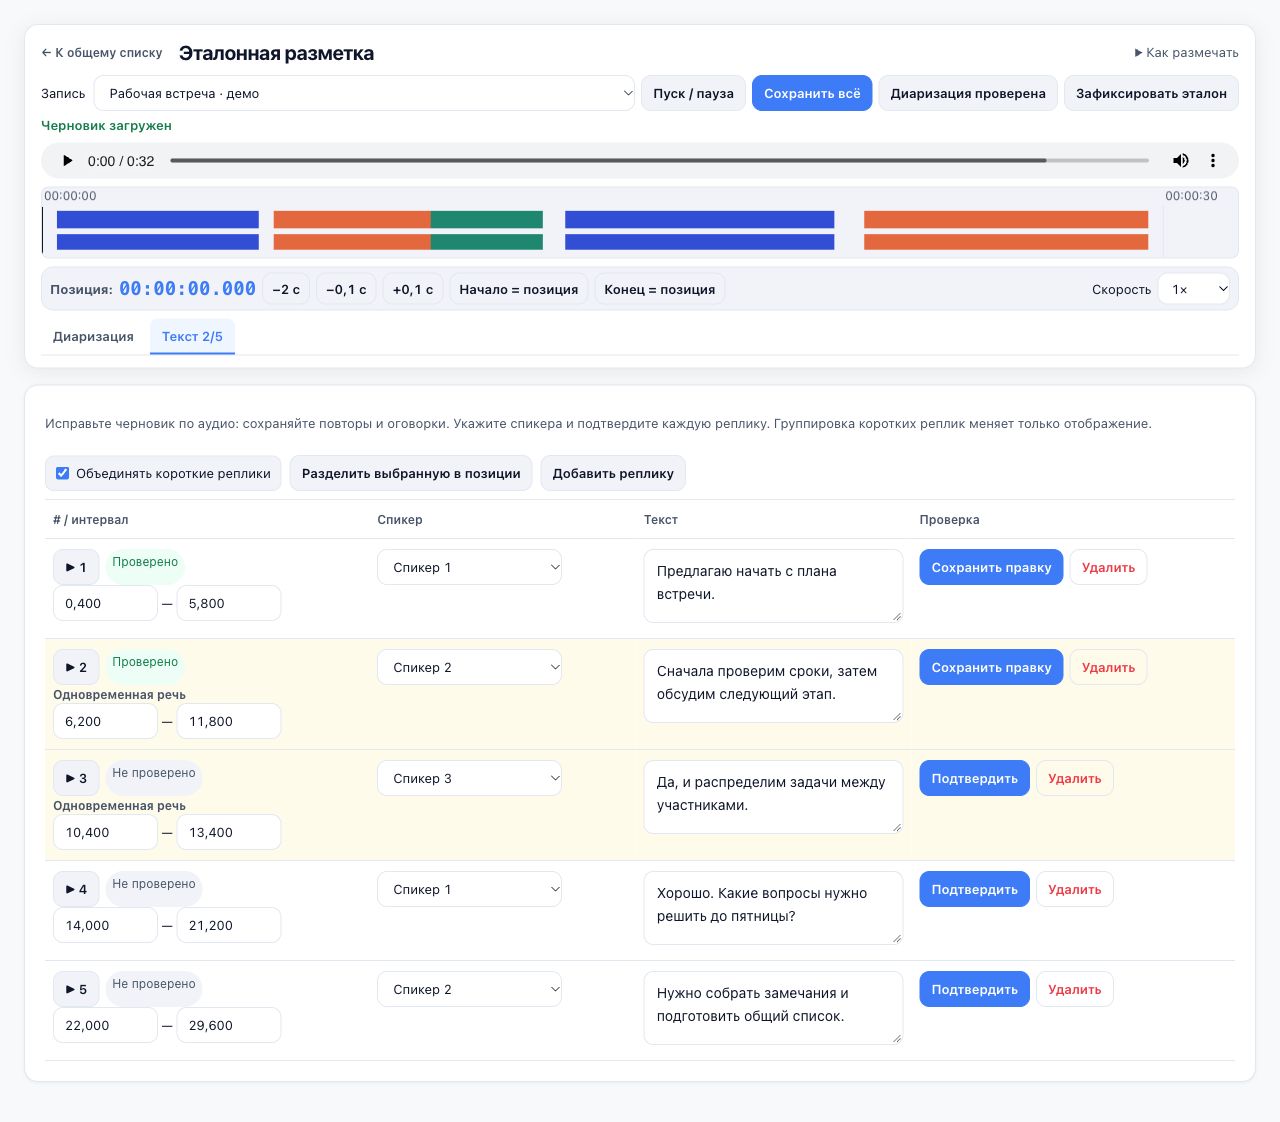
В начале октября были подготовлены черновики для шести реальных встреч. Это заготовки для работы QA: сам факт их подготовки ещё не означает, что шесть встреч полностью проверены или на них уже получен новый сравнительный результат.
Качество пришлось дополнить скоростью и устойчивостью
В первых тестах Community-1 требовала почти столько же времени, сколько длится запись. На 15-минутном фрагменте локальный прогон на Apple M4 CPU занял 1 106,027 секунды, а повтор на VPS с 8 vCPU AMD EPYC без GPU — 862,134 секунды. RTF, отношение времени обработки к длине аудио, снизился с 1,2289 до 0,9579. Это время диаризации; вместе с GigaAM серверный цикл занял 948,518 секунды, то есть дольше 15 минут.
Первого успешного замера ресурсов было мало. Запас до порога в 900 секунд составлял около 38 секунд, а на фрагменте I строгий DER между платформами различался на 0,1431 процентного пункта при установленном допуске 0,05. Поэтому ранний отчёт ещё не давал основания автоматически переключать рабочую систему.
Длинные записи выявили отдельную эксплуатационную проблему. При загрузке стратсессии память Dashboard достигла 4,9 ГБ, Linux завершил процесс из-за нехватки памяти, и импорт прервался. Мы вынесли обработку в отдельный worker: задание и промежуточные результаты сохраняются, перезапуск веб-интерфейса не должен обрывать работу, а общий лимит ресурсов распространяется и на дочерние процессы. После обычных сбоев предусмотрено восстановление; после нехватки памяти повтор блокируется до разбора причины.
В течение сентября worker заработал в рабочем окружении. Затем мы занялись CPU-оптимизацией Community-1. В журнале задач результат зафиксирован 28 сентября: четыре потока PyTorch, пакет из четырёх фрагментов для сегментации и пакет из одного для извлечения признаков спикеров. Маски нескольких спикеров внутри фрагмента стали обрабатываться за один общий проход WeSpeaker вместо повторного прохода для каждого.
На проверочных записях ускорение диаризации составило 2,57–2,84 раза при сохранении временных шкал. На последней записи в этом отчёте RTF диаризации составил 0,288, полного цикла — 0,405. Последнее соответствует примерно 24 минутам обработки на час аудио при таком же соотношении времени. Это отдельный поздний замер; напрямую сравнивать его с ранним 15-минутным тестом как результат на одном корпусе нельзя.
У внешнего сервиса в наших пробах оставалось преимущество по скорости. Поэтому выбор для продукта требует одновременно оценивать качество, время ожидания и ресурсы. Точный текст с правильными спикерами полезен только тогда, когда обработка регулярно доходит до результата.
Что у нас получилось и что проверим дальше
За этот этап у нас появилась рабочая связка для офлайн-встреч, пословное назначение спикеров, первые сравнения на ручной разметке и инструмент для накопления следующих эталонов. Мы также научились отдельно видеть ошибки модели, ошибки совмещения текста с голосами и сбои обработки длинных записей.
Дальше я хочу закончить независимую разметку подготовленных встреч и сравнить модели на одной зафиксированной версии эталона. В набор должны войти разные условия: переговорная, запись через видеосвязь, короткие ответы, шум и перебивания. Рядом с каждым результатом будем указывать число спикеров, длительность оценённой речи, правила исключений, collar и способ учёта одновременной речи.
Community-1 уже дала нам основание улучшить обработку офлайн-встреч. Следующий шаг — выяснить, на каких типах записей сохраняется выигрыш и где ещё приходится исправлять участников вручную.
Материал может пригодиться коллегам? Отправьте им ссылку на статью.